L'autonomie d'un agent tient à ce qu'on lui prépare, et une partie de la liste est déjà écrite
Une étude menée sur 103 équipes d'ingénierie pendant douze semaines associe les résultats obtenus avec un agent de code à la clarté de la consigne et à la préparation de l'environnement, et ses auteurs concluent que l'autonomie tient moins au modèle qu'à l'espace de travail. Nous en citons les chiffres avec leur base et leur réserve, nous décrivons ce qu'un espace de travail préparé contient, et nous montrons que trois de ses questions recoupent un texte européen que votre entreprise connaît peut-être.

Rédigé par Laurent SOUHY
•4 min de lecture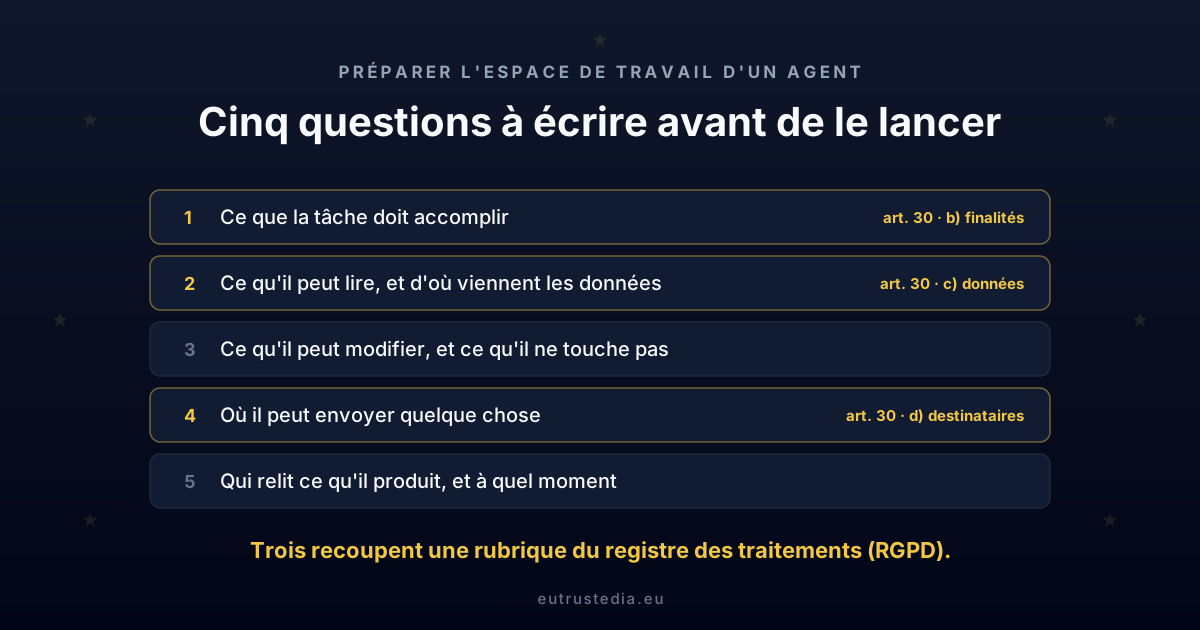
Une étude publiée par Span part d'un constat qu'elle formule ainsi : « The mainstream discourse about AI coding effectiveness tends to focus on model selection. » Le débat sur l'efficacité des agents de code porte surtout sur le choix du modèle. Les auteurs ont regardé ailleurs, et ce qu'ils ont trouvé déplace le travail vers un endroit qui ne se règle pas dans la configuration d'un modèle : ce qu'on écrit avant de le lancer.
Ce que l'étude a mesuré, et comment le lire
L'étude porte sur 103 équipes d'ingénierie, observées pendant douze semaines de développement réel, de mai à juillet 2026. Les sessions complètes entre développeurs et agents ont été notées selon un cadre que les auteurs disent avoir construit par relecture qualitative des traces, grilles de notation structurées et évaluations automatisées « calibrated against human ratings », c'est-à-dire étalonnées sur des notations humaines.
Trois associations en ressortent, et chacune se lit « par point » de la grille de notation de l'étude, jamais en valeur absolue.
Chaque point gagné sur la clarté de la consigne est associé à une baisse de 27,2 % du coût par ligne de code produite par l'agent et effectivement fusionnée dans le projet.
Chaque point gagné sur la préparation de l'environnement est associé à un rendement par tour 88 % plus élevé. Sur les scores observés, de 2,5 à 4,5, les agents produisent environ 5 à 17 lignes fusionnées par intervention humaine.
Chaque point gagné sur le suivi de la qualité est associé à 39 % de cycles de relecture en moins, pour 1 000 lignes de code écrites par l'agent et fusionnées.
L'étude résume ses résultats d'une phrase : « Autonomy is less a property of the model than a property of the workspace you give it. » Autrement dit, en traduction : l'autonomie est moins une propriété du modèle qu'une propriété de l'espace de travail qu'on lui donne.
Deux réserves accompagnent ces chiffres, et elles comptent autant qu'eux. La première est celle des auteurs : « These findings reflect strong observational relationships, not proof of causality. » Ce sont des associations fortes, pas une preuve de cause. La seconde est la nôtre : Span commercialise la mesure de ces pratiques auprès des équipes d'ingénierie. Cela n'invalide aucun chiffre. Cela dit dans quel sens un lecteur prudent doit relire la conclusion.
Enfin, ce que nous n'avons pas : le contenu exact des grilles, c'est-à-dire ce que vaut « un point » de clarté ou de préparation. La page que nous avons consultée ne le publie pas. Ce qui suit n'est donc pas la grille de l'étude. C'est notre propre description.
Ce qu'un espace de travail préparé contient
Préparer l'espace de travail d'un agent revient à écrire, avant qu'il commence, les réponses à cinq questions.
Ce que la tâche doit accomplir, et à quoi on reconnaîtra qu'elle est terminée.
Ce que l'agent a le droit de lire, et d'où viennent les données qu'il verra.
Ce qu'il a le droit de modifier, et ce qu'il ne doit pas toucher.
Où il peut envoyer quelque chose : un service externe, une interface de programmation, une adresse sur internet.
Qui relit ce qu'il produit, et à quel moment.
Aucune ne demande de connaître le fonctionnement interne d'un modèle. Ce sont des questions de description, et c'est précisément ce qui les rend faciles à repousser : tant que l'agent semble fonctionner, rien ne réclame qu'on les écrive.
Où trois de ces questions recoupent un texte déjà écrit
L'article 30 du règlement général sur la protection des données décrit le registre des activités de traitement. Il énumère les informations que ce registre comporte, dont celles-ci :
Ce registre comporte toutes les informations suivantes: […] b) les finalités du traitement; c) une description des catégories de personnes concernées et des catégories de données à caractère personnel; d) les catégories de destinataires auxquels les données à caractère personnel ont été ou seront communiquées, y compris les destinataires dans des pays tiers ou des organisations internationales; […]
Les finalités recoupent notre première question. Les catégories de données recoupent la deuxième. Les destinataires recoupent la quatrième.
Nous ne disons pas si cet article vous concerne, ni comment : c'est une question pour un praticien. Nous constatons autre chose. La personne qui a rédigé cette liste pour un registre et l'équipe qui prépare bien l'espace de travail d'un agent se posent en partie les mêmes questions.
C'est la conviction qui fonde notre travail, et ce recoupement en donne un exemple : une partie du cahier des charges d'un système d'intelligence artificielle bien construit est déjà écrite, et une part s'en trouve dans des textes réglementaires. D'autres référentiels, publics eux aussi, en décrivent d'autres parts.
Ce que cela change pour qui regarde la facture
L'étude associe une consigne plus claire, au sens de sa propre grille, à un coût moindre par ligne fusionnée. Nous ne savons pas si nos cinq questions relèvent de cette grille.
Ce que nous en tirons, et que l'étude ne dit pas : si les réponses écrites à ces questions servent à préparer un agent, elles servent aussi à expliquer ce qu'il fait, avec quelles données et vers où. Une même page pourrait donc servir deux fois, à celui qui paie la facture et à celui qui demande des comptes. C'est une hypothèse, pas une mesure, et nous la donnons comme telle.
Ce que nous ne disons pas
Ni que l'étude établit une cause, ni que nos cinq questions reproduisent sa grille, ni qu'écrire ces réponses fera baisser vos coûts. Nous disons que ces réponses existent ou n'existent pas, et que cela se vérifie en quelques minutes, en ouvrant le fichier que votre agent lit avant de commencer.
Poursuivre la lecture
Trois articles qui prolongent celui-ci.
La limite que le fournisseur a écrite avant qu'on la lui trouve
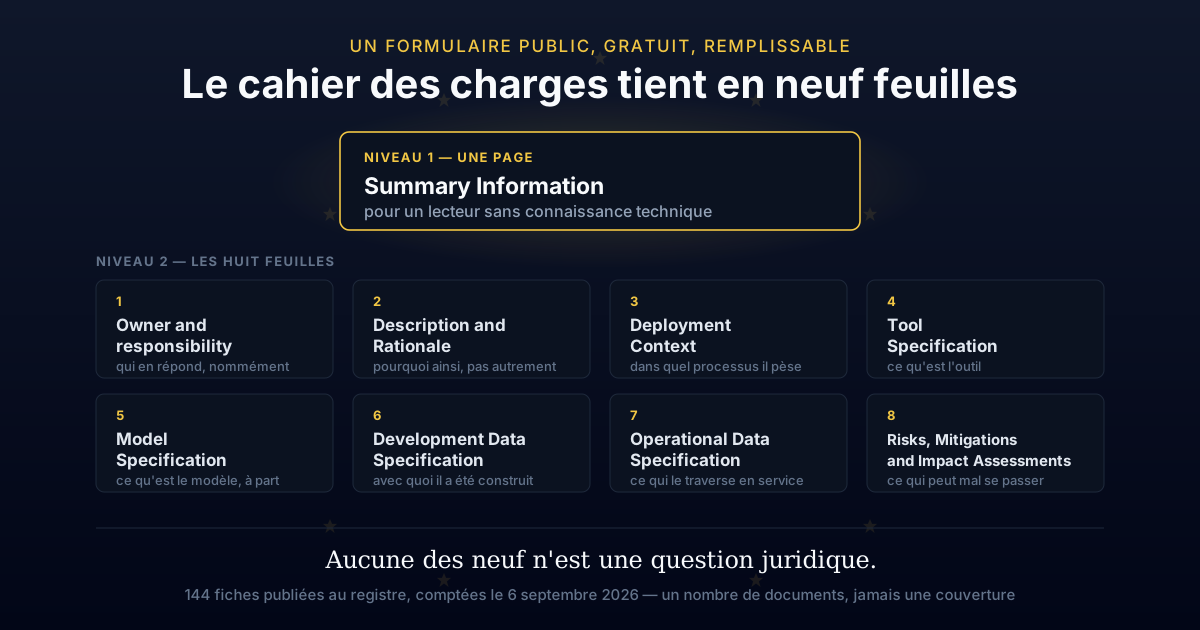
Neuf feuilles : le cahier des charges d'un système d'IA existe déjà, et il est public